O que está associado ao rendimento escolar?
Além das características demográficas, quais fatores familiares, socioeconômicos, tecnológicos e escolares se associam à nota final e ajudam a identificar estudantes em risco?
Análise de segmentação pedagógica,controle de múltiplos testes, diagnóstico de multicolinearidade (VIF), modelagem cumulativa OLS robusta (HC3), machine learning com Random Forest e clusterização multifatorial com K-Means.
Da pergunta de pesquisa às decisões que escolas e gestores podem priorizar.
Além das características demográficas, quais fatores familiares, socioeconômicos, tecnológicos e escolares se associam à nota final e ajudam a identificar estudantes em risco?
Como Cientista Social e ex-professora, escolhi um tema que me é pessoalmente caro: analisar dados educacionais e transformar os resultados em subsídios para decisões pedagógicas.
Tracei hipóteses iniciais baseadas na literatura de Sociologia da Eduação, no meu background como Analista de Dados, Cientista Social e professora, e em buscar resultados altamente acionáveis para gestores pedagógicos e de políticas públicas.
Na base de 12.025 estudantes, apliquei testes estatísticos com correção para múltiplas comparações (Holm/FDR), diagnóstico de multicolinearidade (VIF), modelos OLS cumulativos com erros robustos HC3, comparação preditiva entre Dummy, regressão linear e Random Forest, e K-Means (K=4) validado por cotovelo, silhueta e PCA.
O modelo completo explica 20,9% da variação das notas (R² ajustado). Em associação com a nota, baixa renda aparece com −5,76 p.p. frente à alta renda; +10 p.p. de frequência, +2,2 p.p.; computador em casa, +0,94 p.p.; cada hora semanal de estudo, +0,18 p.p.
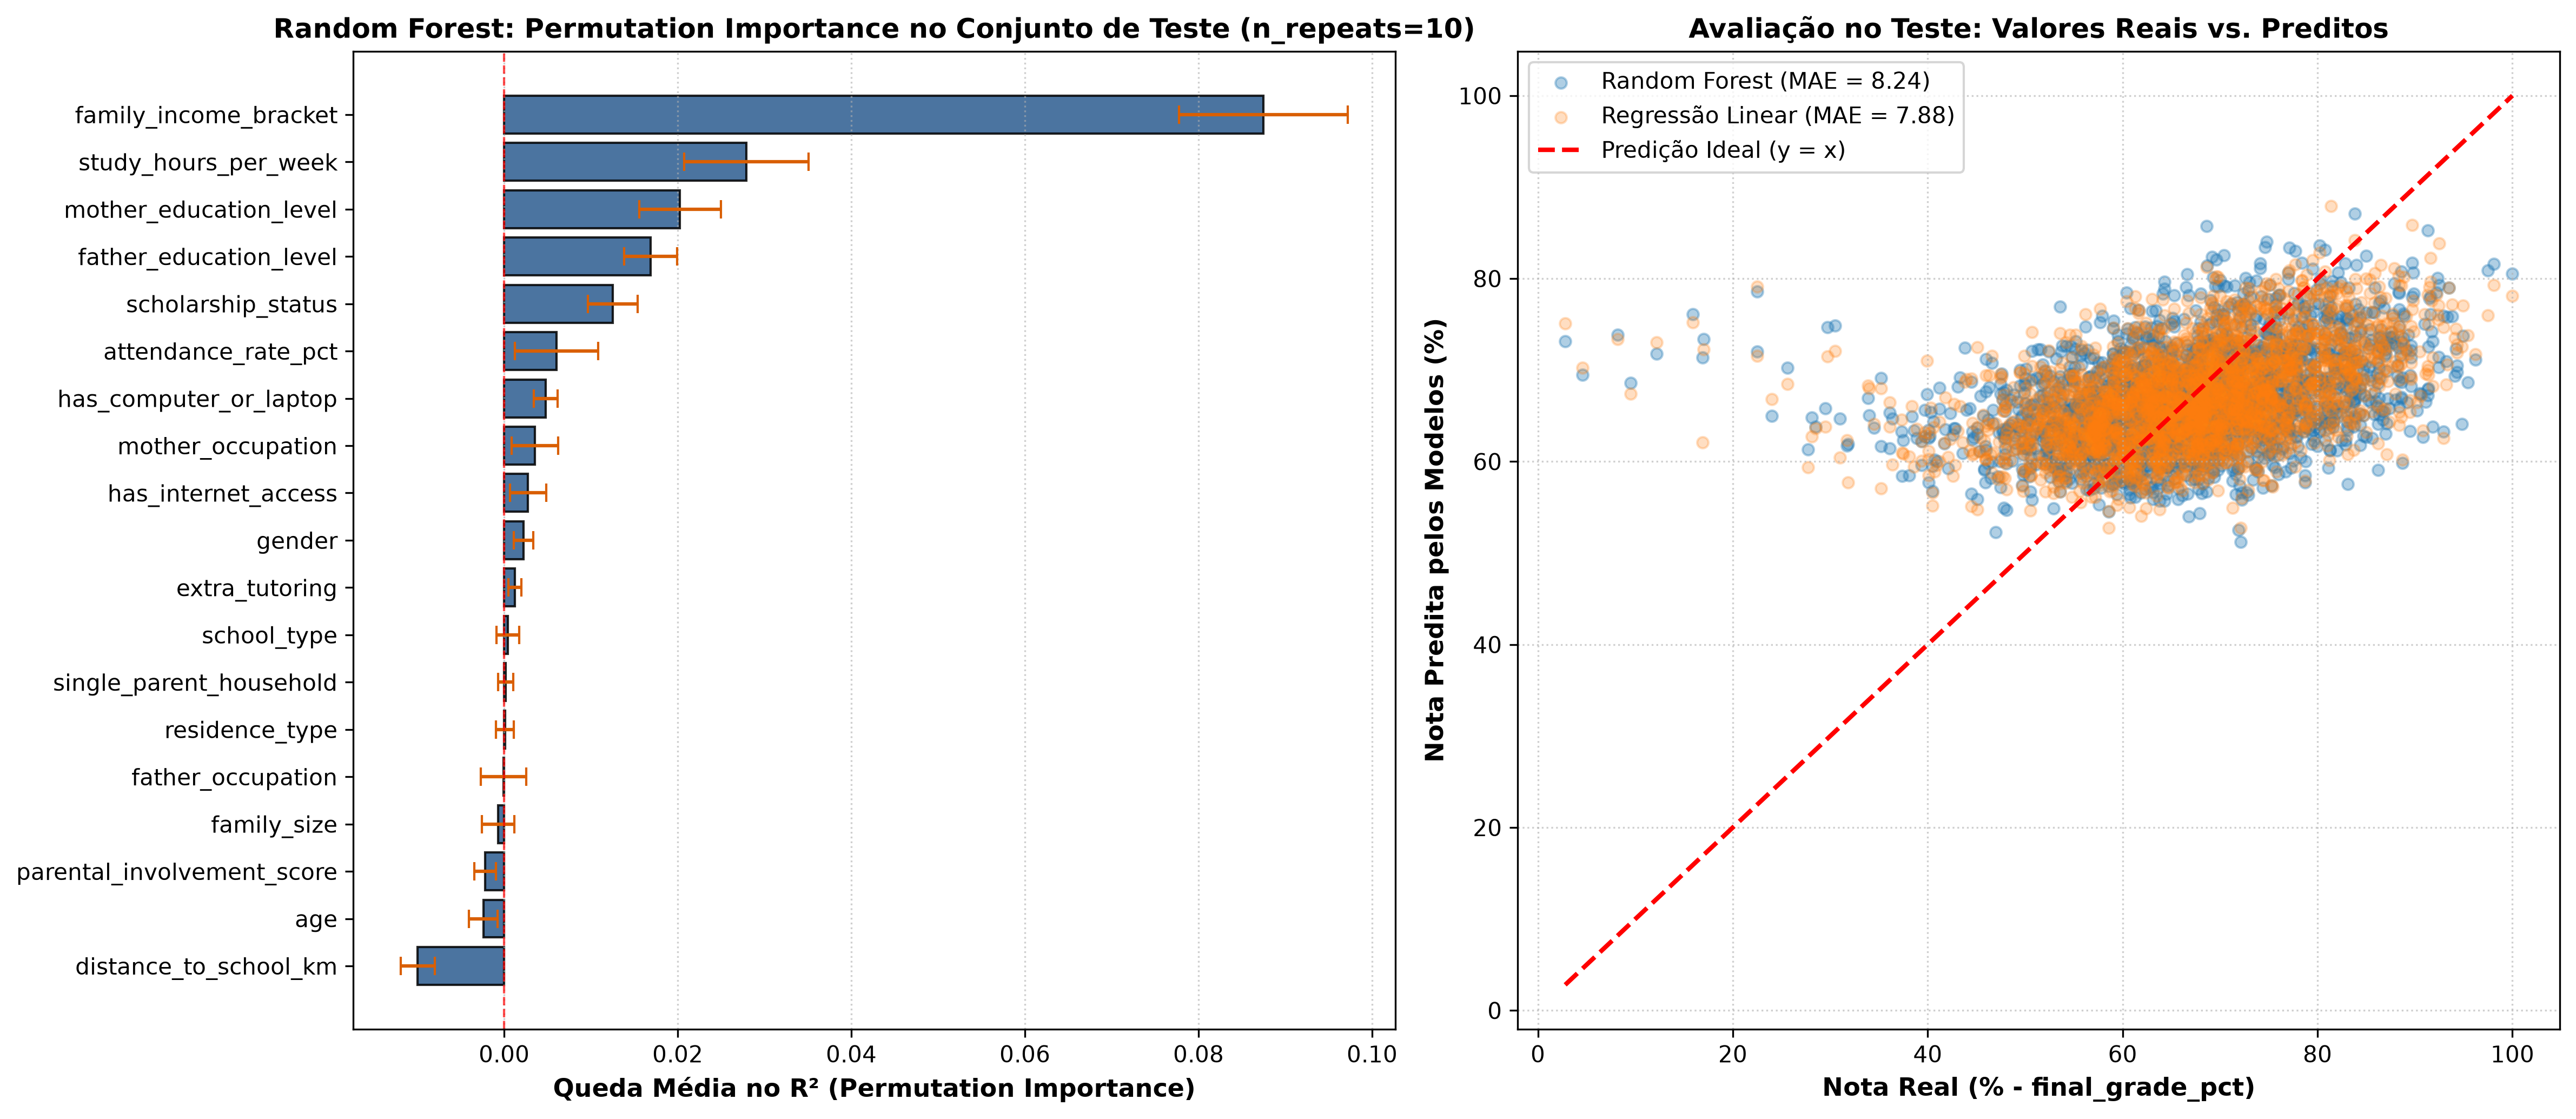
A regressão linear generalizou melhor que o Random Forest no teste (R² 0,193 vs. 0,120; MAE 7,88 vs. 8,24). A importância por permutação destacou renda familiar, horas de estudo e escolaridade dos pais.
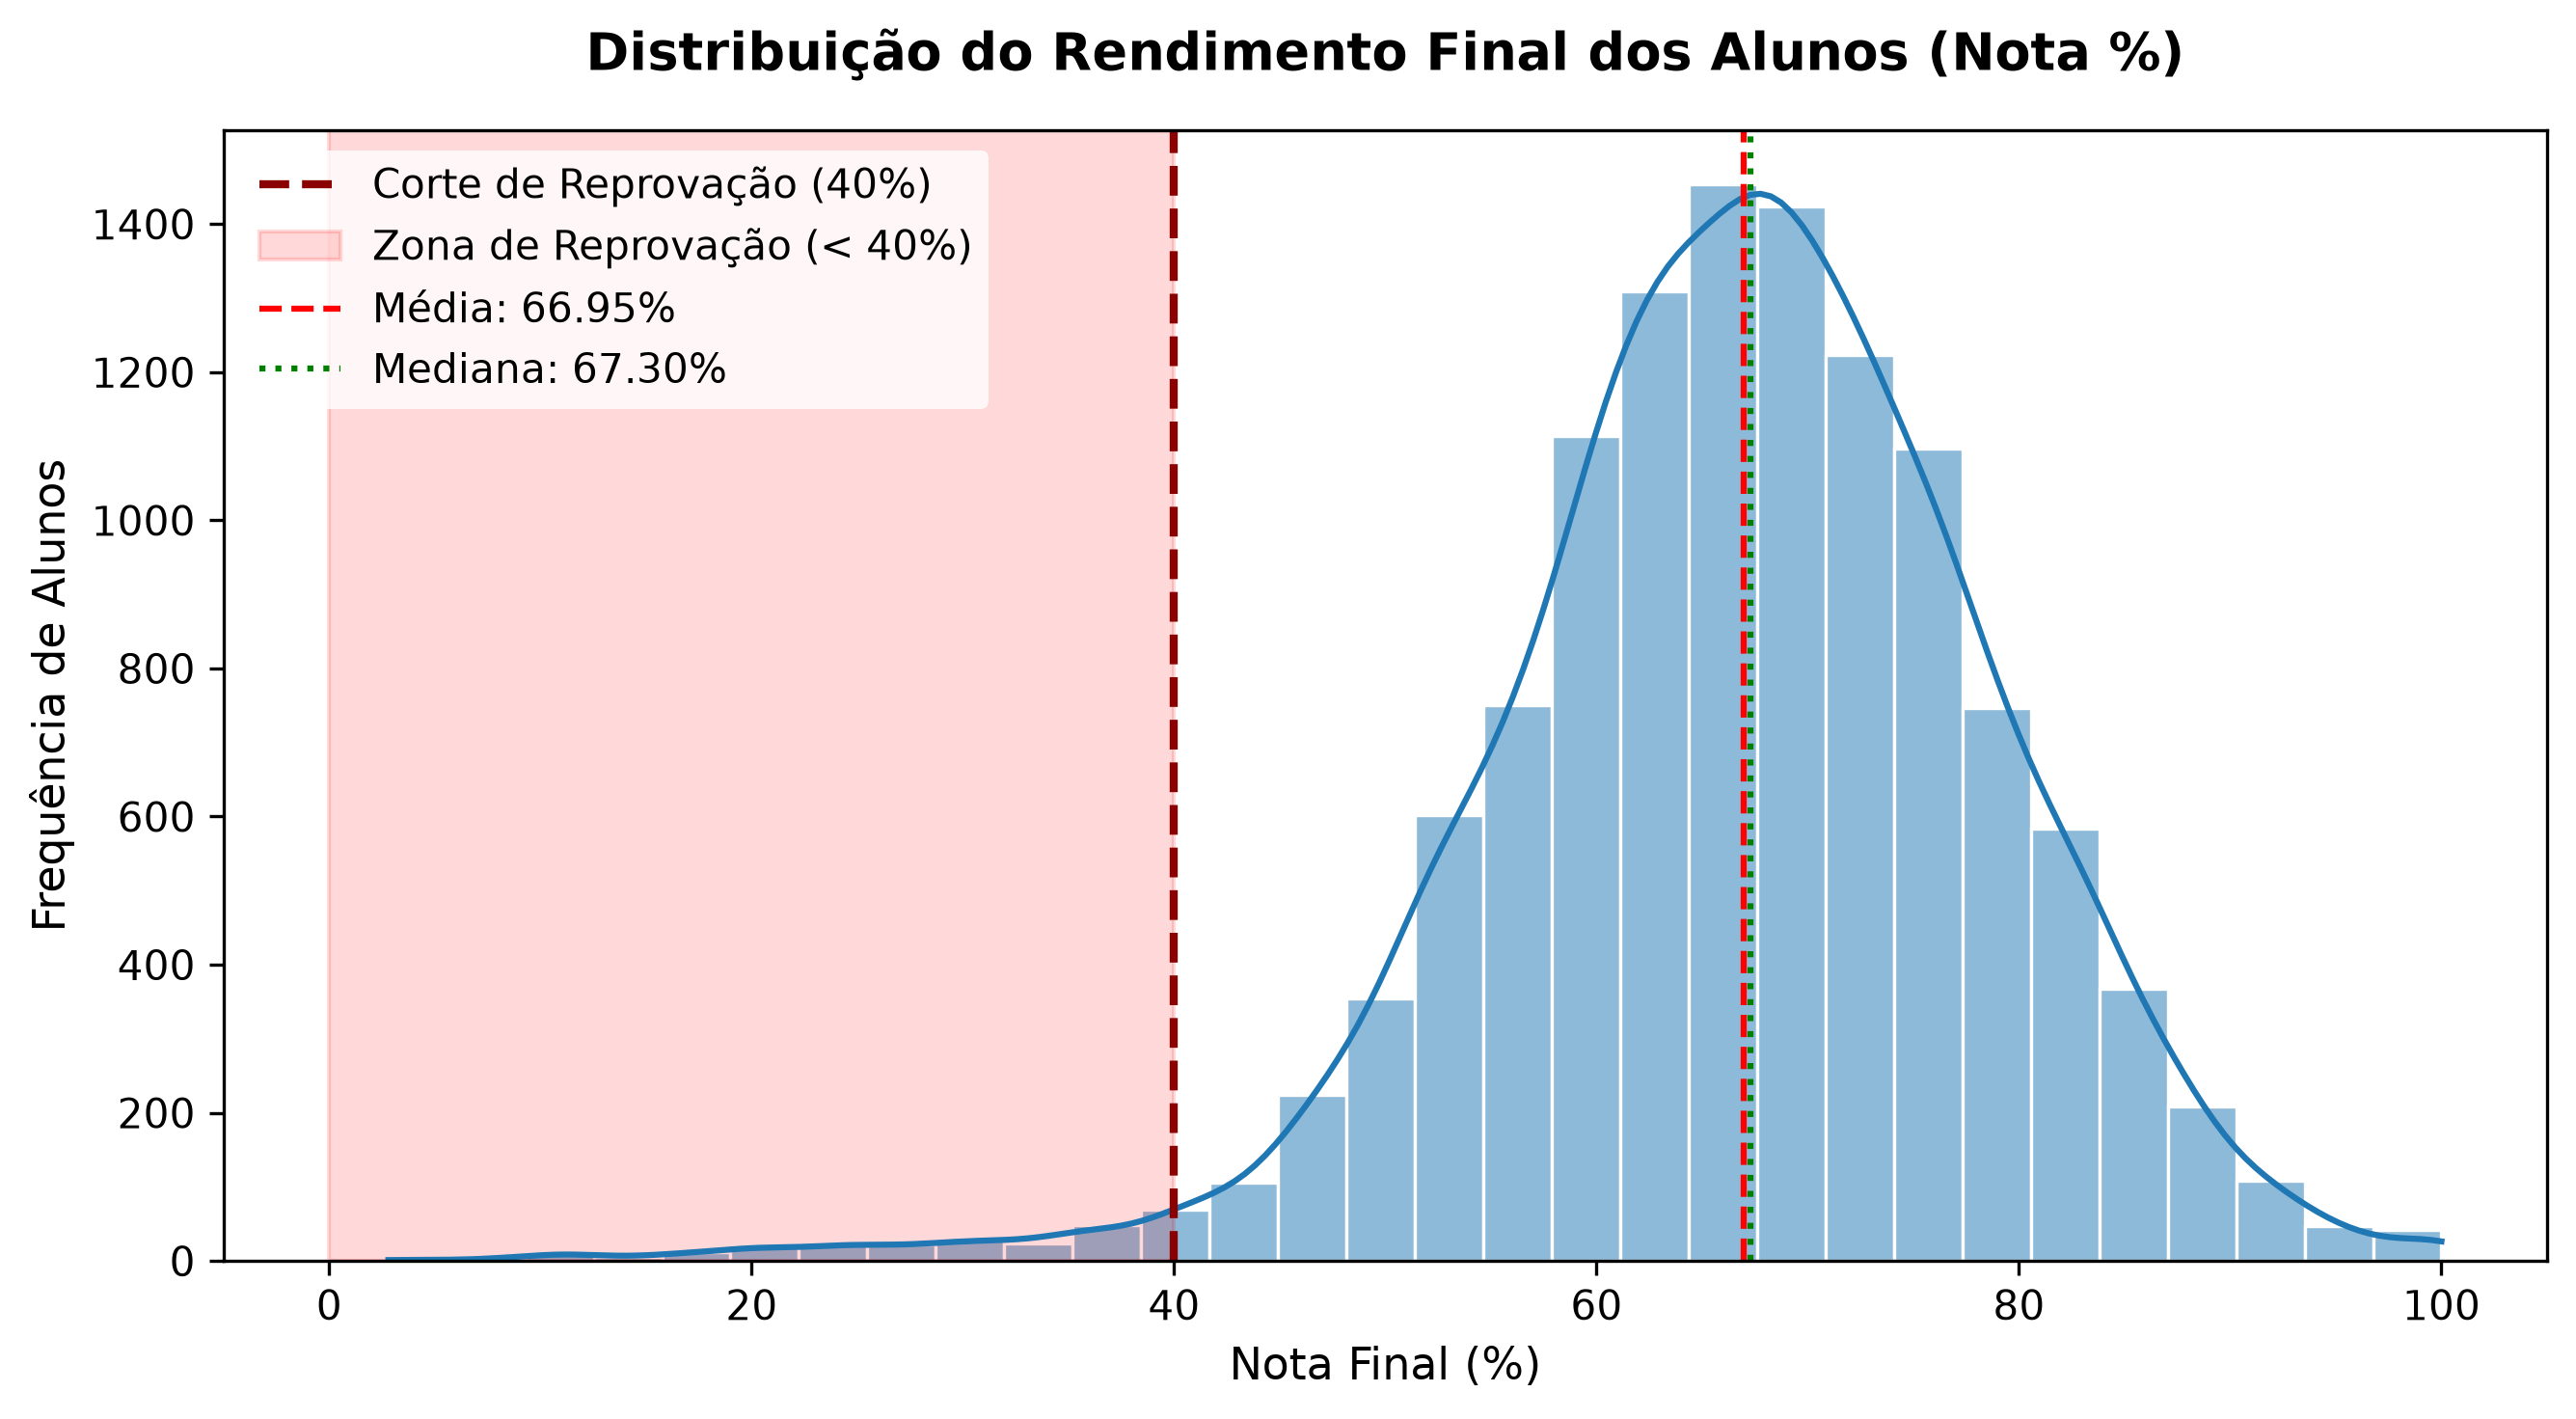
Foram identificados grupos de risco (9,3%; nota média 38,8%), baixo rendimento (29%), na média (40%) e alto rendimento (21,7%). O grupo de risco também tem frequência média de 73,7%.
Busca ativa para enfrentar faltas, conectividade prioritária, tutoria individualizada e acompanhamento com as famílias.
Reforço no contraturno e acesso a laboratórios de informática com estudo orientado.
Ensinar métodos de estudo ativo e estimular monitoria entre pares.
Oferecer iniciação científica, olimpíadas e oportunidades de mentoria.
O rendimento escolar e a evasão acadêmica decorrem de uma teia interligada de fatores demográficos, socioeconômicos, estruturais e comportamentais. A preocupação com evasão é compartilhada entre órgãos públicos e educadores. Como Cientista Social e ex-professora, o tema me é caro em uma camada pessoal, o que motivou a escolha para este side-project de análise de dados educacionais e construção de relatório em formato web interativo.
O objetivo central deste estudo é fundamentar decisões pedagógicas em dados por meio de um modelo preditor confiável sobre quais dimensões têm maior peso na nota final e na identificação de grupos de alunos em risco escolar. Deste modo, partimos de uma análise exploratória robusta, seguida de modelagem cumulativa OLS com correção de heterocedasticidade (HC3), e modelos de Feature Importance para identificar quais frentes devem ser atacadas por meio de políticas públicas de inclusão e permanência, ao lado de uma clusterização K-Means validada para segmentação pedagógica.
Os resultados apontam um cenário claro para gestores e educadores: é necessário atacar a carência de infraestrutura digital, engajar os responsáveis e criar programas de reforço escolar e monitoria entre pares. Alunos isolados e sem apoio pedagógico e familiar tendem a permanecer em um ciclo de baixo rendimento e risco de reprovação, enquanto aqueles com suporte adequado podem alcançar alto desempenho acadêmico. Políticas de Inclusão e Permanência que aliem suporte pedagógico, engajamento da família e acesso à tecnologia têm maior eficácia em combater o baixo rendimento de alunos vulneráveis.
O ponto de partida aqui foi conceitual: a literatura de sociologia da educação sugere que fatores demográficos e socioeconômicos
são mediadores do comportamento escolar, e não determinantes diretos. Para além de rodar modelos
cegamente com todas as variáveis disponíveis,
ancorei as decisões analíticas neste norte: o que interfere no rendimento acadêmico de
alunos para além de características demográficas? Agrupamos as features em 4 blocos e ajustamos modelos incrementais,
monitorando o ganho de explicação real (R² ajustado) e o balanço de parcimônia dado pelo
Critério de Informação de Akaike (AIC)
O segundo ponto de partida foi a acionabilidade: é importante que os resultados do modelo possam ser traduzidos em políticas públicas e ações pedagógicas que efetivamente sejam aplicáveis à realidade das escolas. Por isso, a clusterização K-Means foi validada e segmentou os alunos em 4 grupos distintos: alunos de alto rendimento, alunos de médio rendimento, alunos de baixo rendimento e alunos em situação de risco. Isso permite criar planos de ação pedagógicos específicos para cada perfil, otimizando recursos públicos e maximizando o impacto das intervenções.
| Modelo Cumulativo | Qtd Variáveis | R² | R² Ajustado | AIC (Akaike) | BIC | F-Estatística (p-valor) |
|---|---|---|---|---|---|---|
| Modelo 1: Demografia (idade/gênero) | 1 | 0.0002 | 0.0001 | 74.799,4 | 74.813,7 | 1.70 (p = 0.192) |
| Modelo 2: + Estrutura Familiar & Renda | 25 | 0.1724 | 0.1702 | 73.033,7 | 73.220,3 | 80.11 (p < 0.001) |
| Modelo 3: + Inclusão Tecnológica | 27 | 0.1828 | 0.1805 | 72.915,9 | 73.116,9 | 79.79 (p < 0.001) |
| Modelo 4: Completo (+ Hábitos Escolares) | 34 | 0.2122 | 0.2094 | 72.576,2 | 72.834,6 | 76.08 (p < 0.001) |
Interpretação Simples dos Resultados: O AIC é o Critério de Informação de Akaike, aplicado à modelos de Machine Learning, é utilizado para avaliar a qualidade de diferentes modelos. Penaliza o overfitting e favorece modelos mais simples, desde que expliquem bem os dados. O AIC caiu drasticamente de 74.799 para 72.576. Menor AIC indica um modelo superior, que premia a capacidade explicativa sem carregar termos redundantes.
Como esperado pela literatura que mobilizei do meu background de Cientista Social, a dimensão escolar (horas de dedicação, apoio institucional via tutorias e frequência) agregou quase 3 pontos percentuais de R² e atenuou a penalidade dos fatores socioeconômicos, demonstrando o efeito mediador do comportamento na realidade econômica e social dos alunos.
A inclusão tecnológica, altamente acionável, tem um impacto de quase 1 ponto percentual na nota final, enquanto a faixa de renda familiar de menor renda acarreta uma perda de quase 6 pontos percentuais. É possível combinar estes dois insights através de políticas de inclusão digital direcionadas de forma mais intensiva para alunos de menor renda.
Devido à presença de heterocedasticidade nos resíduos, isto é, uma dispersão desigual dos erros ao longo das variáveis explicativas
(teste de Breusch-Pagan com p-valor < 0.10 e
Jarque-Bera com assimetria residual),
o modelo foi reajustado com estimador sanduíche HC3 de MacKinnon-White, garantindo
erros-padrão e intervalos de confiança não inflacionados.
O Forest Plot abaixo exibe os coeficientes Beta (impacto percentual na nota) e Intervalos de Confiança de 95% do modelo OLS HC3. Cada ponto percentual de variação em uma variável explicativa corresponde a um impacto percentual na nota final do aluno, mantendo todas as demais condições constantes.
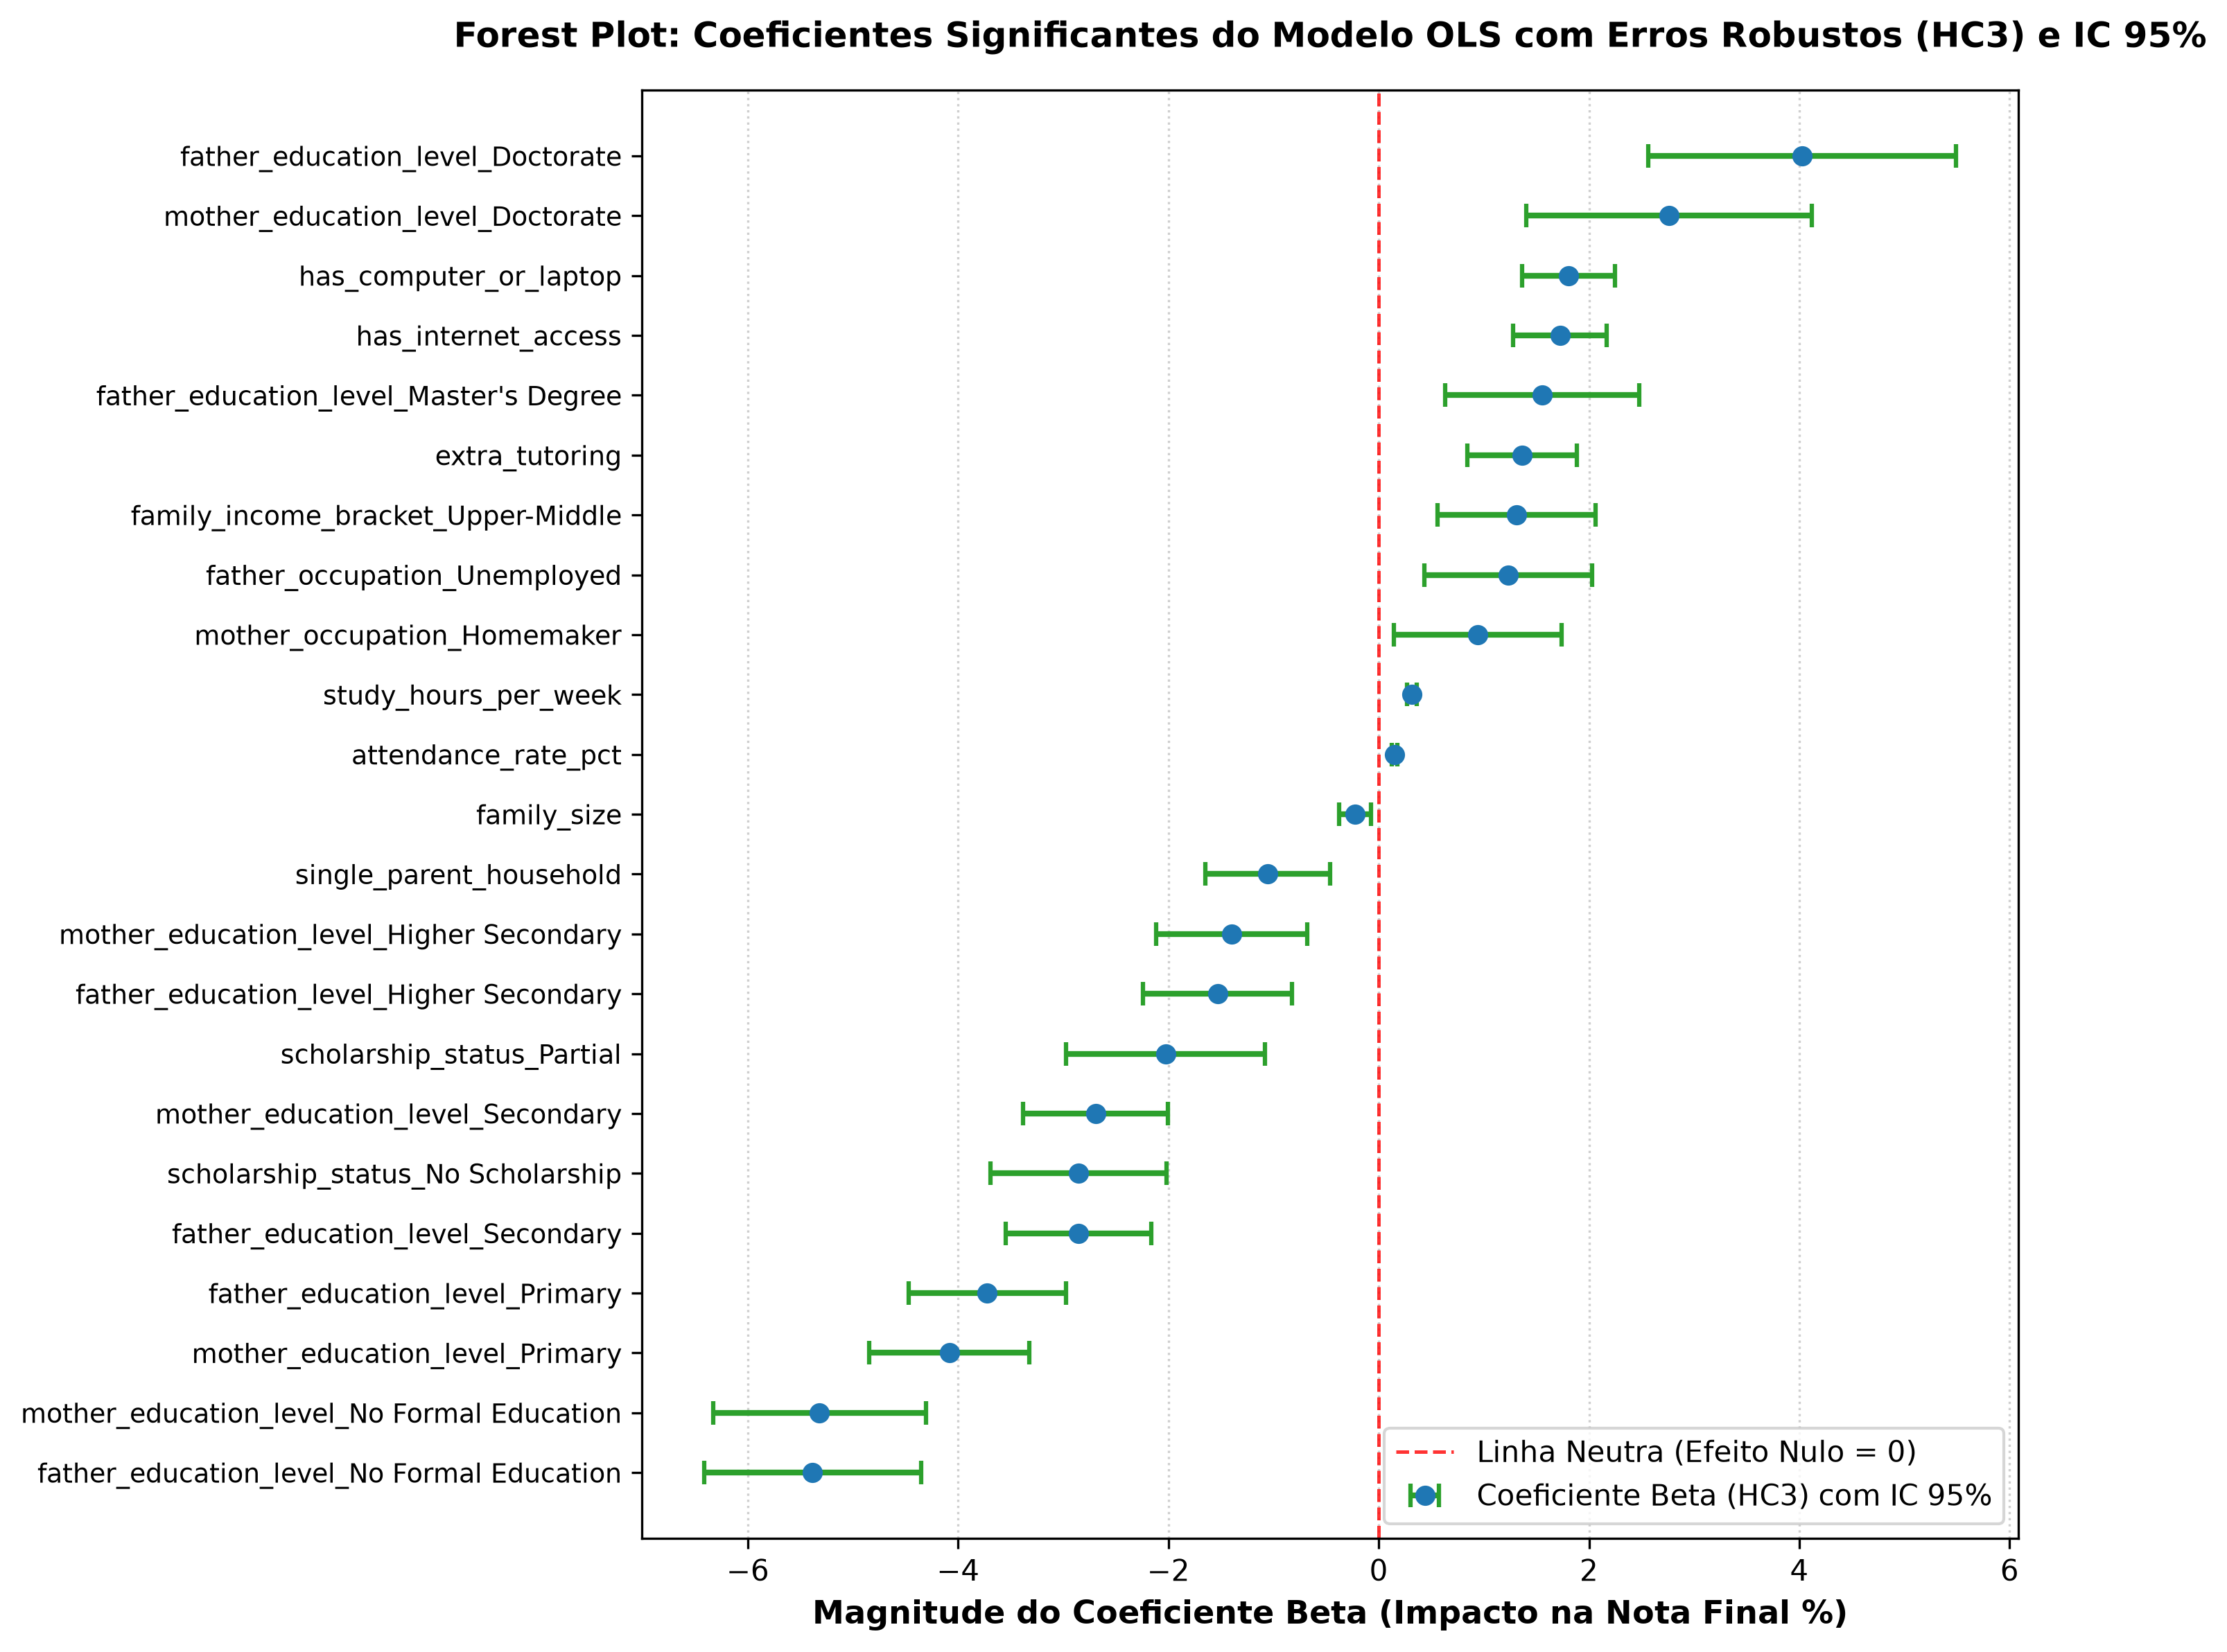
family_income_bracket_Low (β = -5.76): Pertencer à faixa de menor renda familiar
acarreta, em média, uma perda de 5,76 pontos percentuais na nota final do aluno em
relação à faixa de alta renda, mantendo todas as demais condições constantes.attendance_rate_pct (β = +0.22): Cada aumento de 10 pontos percentuais na taxa de
frequência escolar eleva a nota final em aproximadamente 2,2 pontos percentuais.
study_hours_per_week (β = +0.18): Cada hora adicional de estudo extraclasse por
semana agrega em média 0,18 p.p. na avaliação final.has_computer_or_laptop (β = +0.94): A disponibilidade de computador em casa agrega
quase 1 ponto percentual completo na nota média do estudante.
Para validar a capacidade preditiva em ambiente de produção sem vazamento de dados (data
leakage),
estruturamos um ColumnTransformer acoplado ao Pipeline scikit-learn com
partição 80/20 (treino/teste, seed=42).
Comparamos o Random Forest contra dois baselines essenciais:
| Modelo Avaliado | CV MAE Treino (Média ± Std) | CV R² Treino (Média ± Std) | MAE Teste (Inédito) | R² Teste (Inédito) | Diagnóstico de Ajuste |
|---|---|---|---|---|---|
| Dummy Regressor (Média) | 8.9832 ± 0.046 | -0.0015 ± 0.001 | 8.9314 | -0.0001 | Linha de Base Pura |
| Regressão Linear Múltipla | 7.8115 ± 0.061 | 0.2008 ± 0.015 | 7.8767 | 0.1929 | Melhor Equilíbrio e Generalização |
| Random Forest Regressor (100 árvores) | 8.1548 ± 0.054 | 0.1486 ± 0.014 | 8.2386 | 0.1203 | Sensível a Ruído / Sobreajuste Leve |
Para educadores e gestores públicos isso tem um significado acionável claro: para além da faixa de renda familiar, não passível de intervenção direta, é possível atuar incentivando o estudo extraclasse e promovendo programas de capacitação e engajamento dos pais.
Por que a Feature Importance é crucial? A importância tradicional de árvores baseada na impureza de Gini superestima fortemente variáveis contínuas com alta cardinalidade. A Feature Importance mede a perda direta de R² ao embaralhar os valores de cada coluna no conjunto de teste. O diagnóstico confirma que faixa de renda familiar (queda de 0,087 no R²), horas semanais de estudo (0,028) e nível de instrução dos pais são as variáveis de real relevância causal na predição.
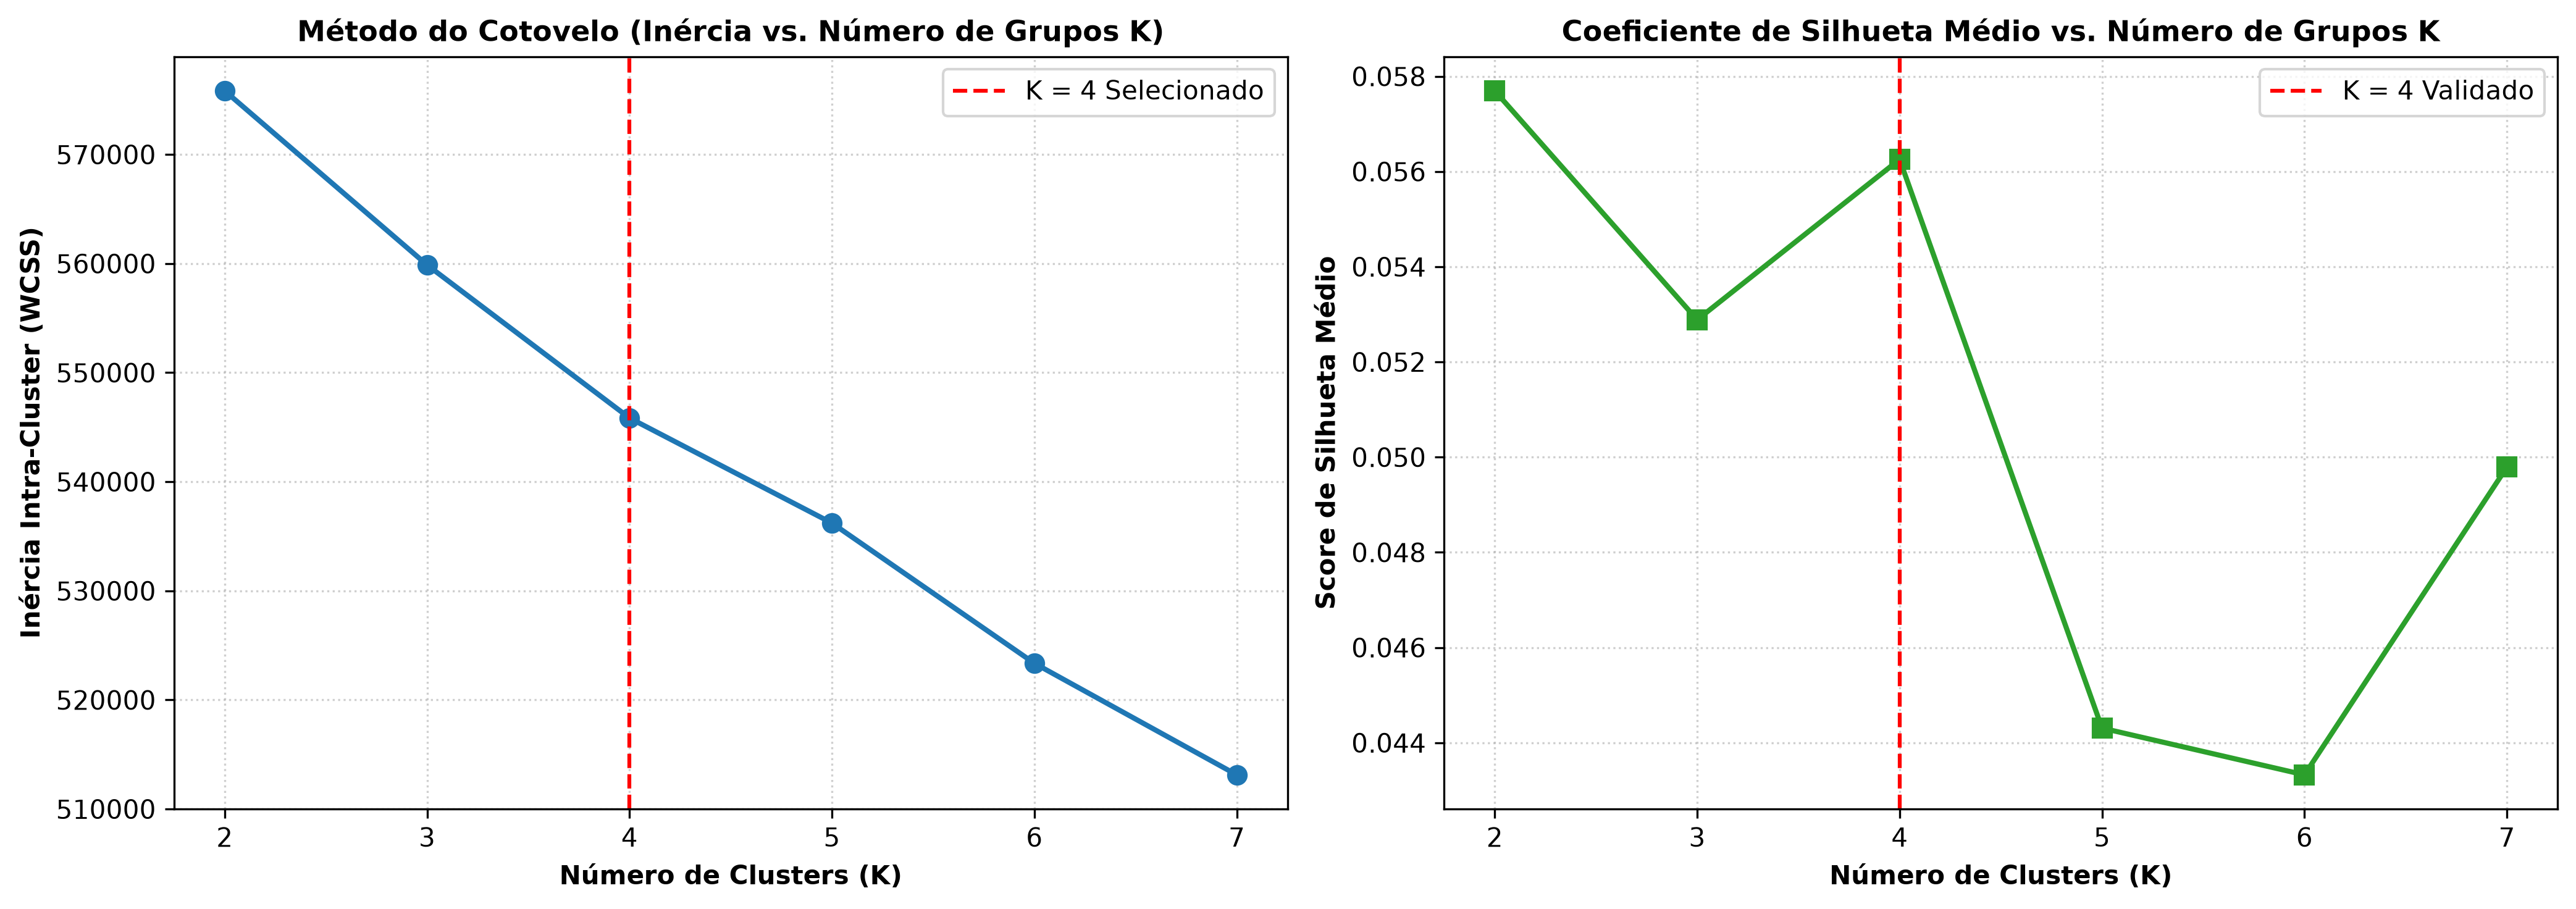
A definição do número de grupos foi fundamentada na literatura pedagógica (4 quadrantes de risco/rendimento) e validada pelas curvas de inércia intra-cluster (Elbow Method) e do Coeficiente de Silhueta.
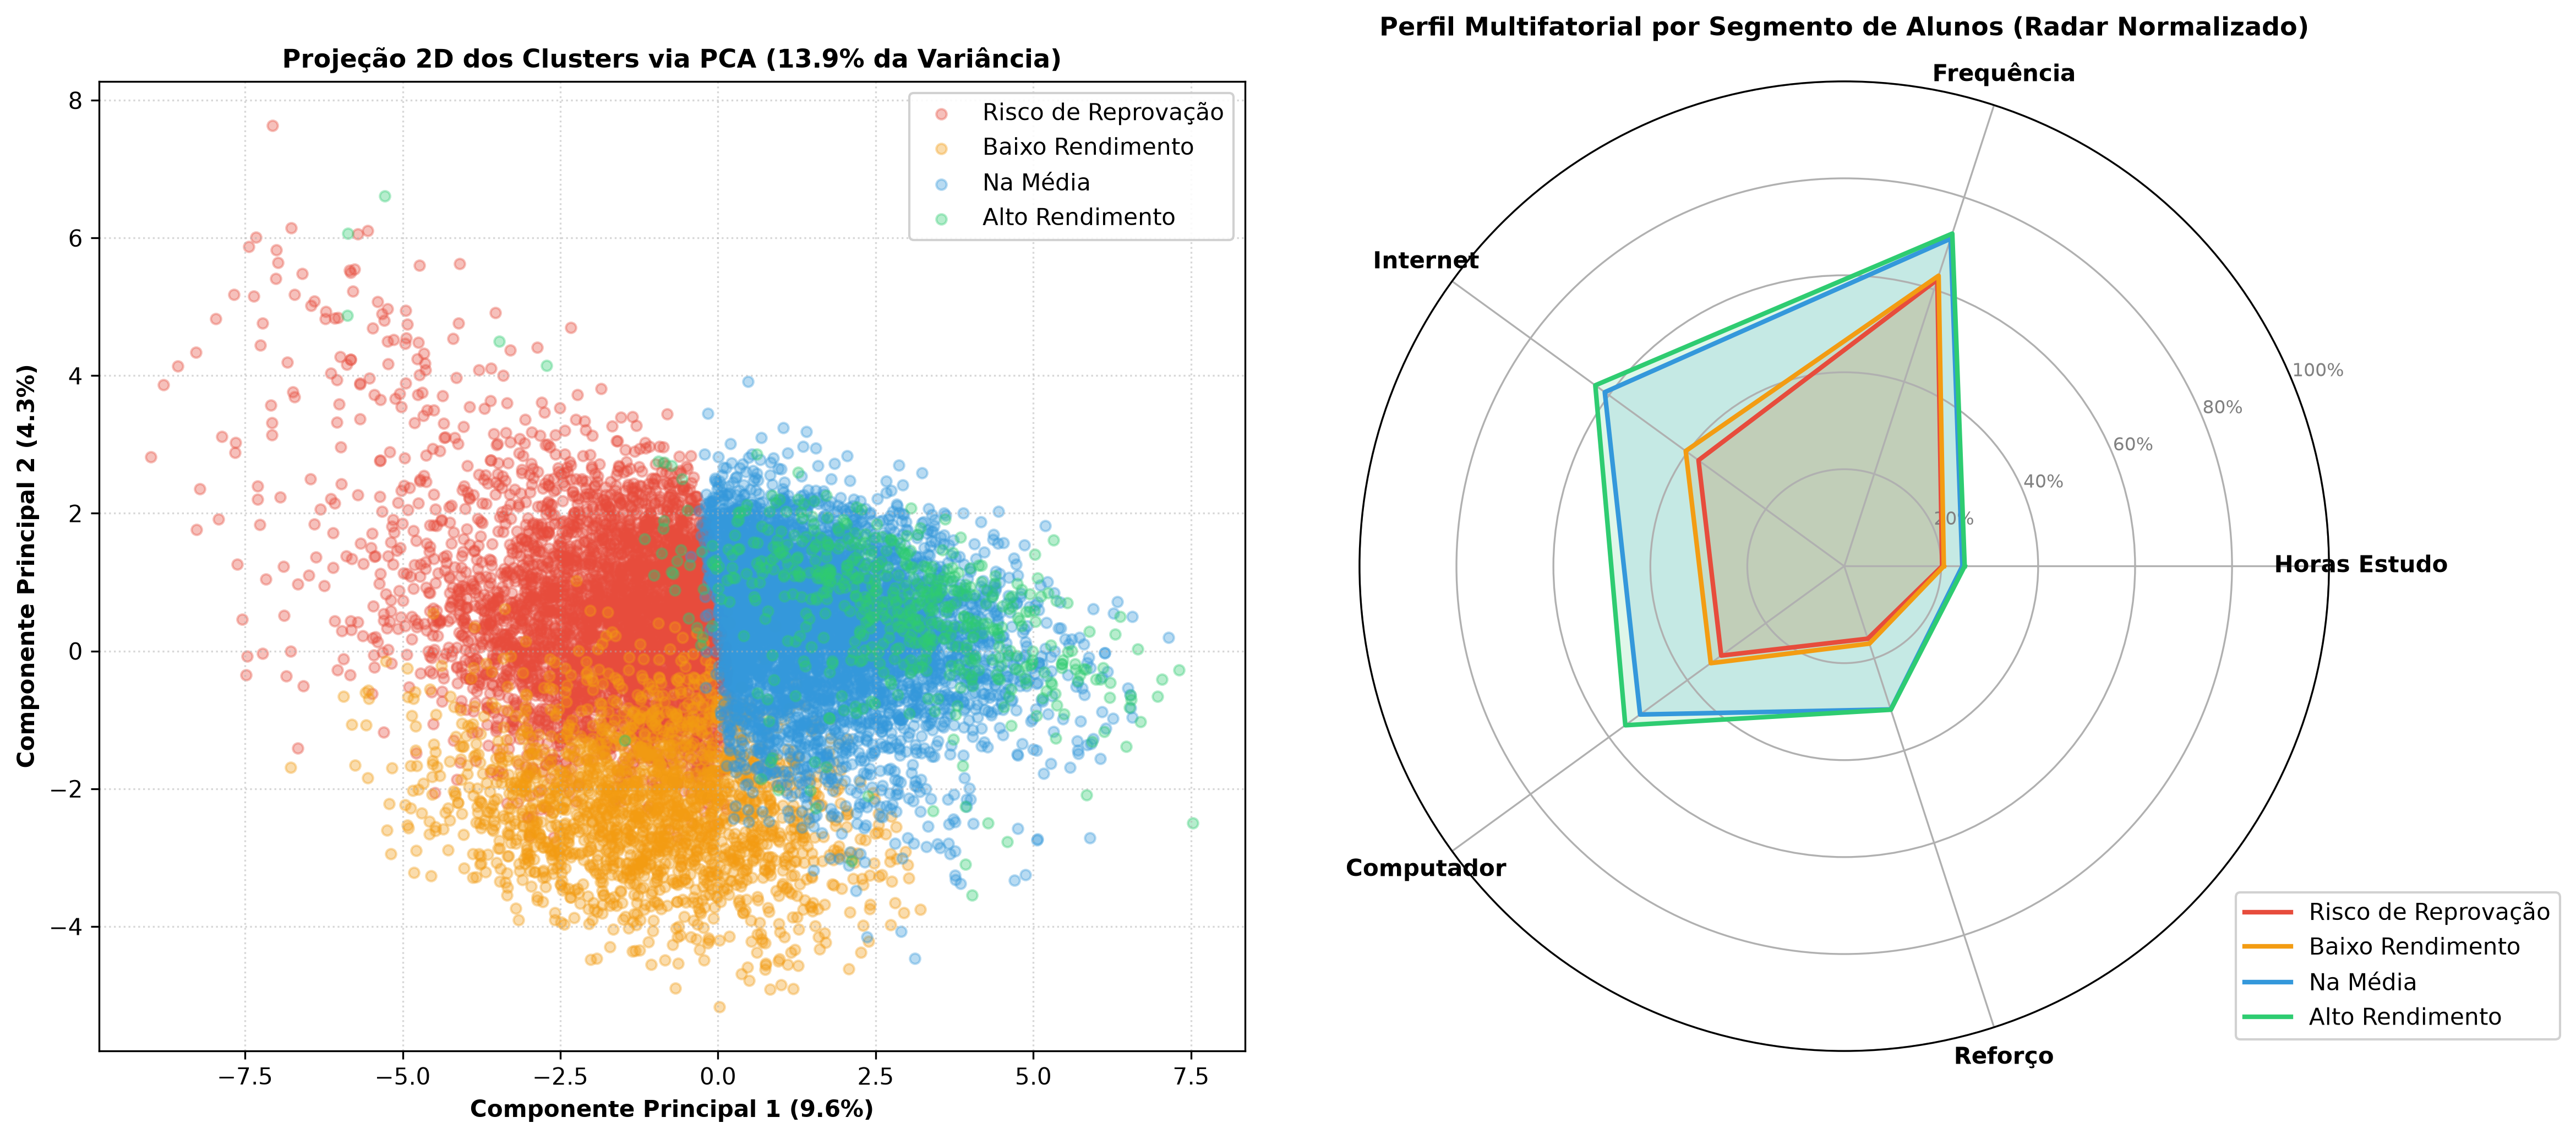
| Perfil do Segmento | Qtd Alunos | % Base | Nota Média | Frequência Escolar | Horas Estudo/Semana | Acesso à Internet | Possui Computador |
|---|---|---|---|---|---|---|---|
| 1. Risco de Reprovação | 1.119 | 9.3% | 38.8% | 73.7% | 10.4 h | 23.0% | 33.0% |
| 2. Baixo Rendimento | 3.487 | 29.0% | 53.1% | 81.8% | 14.7 h | 61.0% | 52.0% |
| 3. Na Média | 4.810 | 40.0% | 64.9% | 86.8% | 18.9 h | 84.0% | 78.0% |
| 4. Alto Rendimento | 2.609 | 21.7% | 73.8% | 91.1% | 26.6 h | 93.0% | 90.0% |
Este projeto foi construído com uma abordagem inicial pouco robusta que foi posteriormente refatorada para uma metodologia mais confiável e acionável. Isso se deu por meio de peer review com colegas e comunidades de data science no Reddit, Discord, Stack Overflow e Telegram, contribuindo para meu aprendizado sobre a teoria estatística, complementar à minha experiência prática em educação e conceitual como Cientista Social. A seguir, apresentamos um comparativo técnico entre a abordagem inicial e a abordagem robusta implementada, destacando as melhorias significativas em termos de controle de erros, validação de modelos e segmentação pedagógica.
ColumnTransformer estritamente acoplada após
train_test_split.HC3.Os resultados apontam um cenário claro para gestores e educadores: é necessário atacar a carência de infraestrutura digital, engajar os responsáveis e criar programas de reforço escolar e monitoria entre pares. Alunos isolados e sem apoio pedagógico e familiar tendem a permanecer em um ciclo de baixo rendimento e risco de reprovação, enquanto aqueles com suporte adequado podem alcançar alto desempenho acadêmico.
| Perfil do Aluno | Diagnóstico Central de Vulnerabilidade | Ações Pedagógicas & Políticas de Intervenção Recomendadas |
|---|---|---|
| Risco de Reprovação (9.3% da rede) |
Taxa de frequência extremamente baixa (73.7%), forte carência de infraestrutura digital (apenas 23% com internet) e baixo engajamento dos responsáveis, resultando em nota média de 38.8%. | Busca Ativa & Resgate Imediato: Visitas domiciliares para combater o absenteísmo crônico, concessão prioritária de bolsas de conectividade e chips 4G, e alocação em tutoria intensiva individualizada (1:1). Programa de engajamento familiar com workshops de capacitação e acompanhamento do progresso do aluno. |
| Baixo Rendimento (29.0% da rede) |
Frequência escolar regular (81.8%), porém dedicação insuficiente de estudos extraclasse (14.7h/semana) e suporte parcial de tecnologia (apenas metade possui computador). | Reforço Escolar no Contraturno: Criação de salas de estudo orientadas e abertura de laboratórios de informática escolares durante os finais de semana para garantir tempo de prática assistida. |
| Na Média (40.0% da rede) |
Boa assiduidade (86.8%) e infraestrutura satisfatória (78% com computador), mas métodos de estudo dispersos e rendimento estagnado em torno de 64.9%. | Oficinas de Métodos Ágeis de Estudo: Treinamento em técnicas de estudo ativo (Feynman, repetição espaçada, resolução de simulados) e programas de monitoria entre pares para alavancar a retenção do conteúdo. |
| Alto Rendimento (21.7% da rede) |
Alta rotina de estudo (26.6h/semana), frequência acima de 91%, forte engajamento familiar e nota média de 73.8%. | Iniciação Científica & Mentoria: Estímulo à participação em Olimpíadas Científicas, clubes de robótica e projetos interdisciplinares, atuando também como monitores líderes dos alunos em recuperação. |